CPU cache 原理
引言
CPU 和内存运行速度相差很大,CPU 直接访问内存需要 200~300 个时钟周期,这极大浪费了 CPU 的性能,因此需要缓存组件作为缓冲,尽量充分利用 CPU 的性能。
缓存的概念很多地方都有,浏览器缓存、Redis 缓存。都是把数据存到离核心区更近的地方,加快数据访问。浏览器把服务端数据缓存到用户端,Redis 把磁盘数据缓存到内存,CPU 缓存则是把内存数据存到 CPU 缓存。读取流程也相似,先去缓存找数据,缓存如果有数据直接返回,缓存没有则去数据源处加载到缓存中,再读取使用。
CPU Cache 架构
CPU Cache 分 L1、L2、L3 三级缓存,其中 L1、L2 由每个 CPU 核心独享,L3 在 CPU 核心之间共享。
之所以分级而不是搞一个超大缓存,本质是容量与速度的权衡:越靠近核心的缓存速度越快、容量越小、造价越高。
| 层级 | 归属 | 典型容量 | 典型延迟 | 说明 |
|---|---|---|---|---|
| L1 | 每个核心独享 | 32KB~64KB | 1~4 个时钟周期 | 最快,通常分指令缓存和数据缓存 |
| L2 | 每个核心独享 | 256KB~1MB | 10~20 个时钟周期 | 比 L1 大,稍慢 |
| L3 | 核心间共享 | 8MB~32MB | 40~60 个时钟周期 | 所有核心共享,容量最大 |
| 内存 | 全局 | 8GB~64GB+ | 200~300 个时钟周期 | 慢一个数量级 |
表中容量和延迟是示意值,不同架构(Intel、AMD、Apple Silicon)差异很大,但数量级关系是稳定的:L1 最快最小,内存最慢最大。
为什么缓存能命中:局部性原理
缓存容量远小于内存,凭什么大部分时候都能"猜对"数据在缓存里?答案就是局部性原理(Principle of Locality):
- 时间局部性(Temporal Locality):一个数据被访问后,很可能在短时间内再次被访问。比如循环里反复读同一个变量、反复调用同一个函数。
- 空间局部性(Spatial Locality):一个数据被访问后,它附近的地址很可能也会被访问。比如顺序遍历数组、执行顺序排列的指令。
局部性就是缓存存在的理论依据。有了它,缓存才能用很小的容量换来很高的命中率。反过来,缓存的设计也处处围绕局部性:缓存行一次搬 64 字节而不是 4 字节,就是利用空间局部性;LRU 等替换策略保留"最近使用过"的数据,就是利用时间局部性。
CPU Cache 读取的底层原理
CPU 的指令周期可以简化为取指、译码、执行、访存、写回几个阶段。如果取到的是内存读取指令,会在访存阶段通过地址总线访问内存,读取数据。指令中的内存地址是查找数据的关键:
假设一台计算机内存 64GB,则内存地址需要 36 位才能覆盖全部内存(64GB = 2^36 B)。缓存的造价高、容量小,L1 数据缓存通常在 32KB,很明显 32KB 存不下 64GB 的内存数据,而且也没必要把所有数据都存入缓存,因为数据有使用频率的区别,有的数据可能很长时间内都不会被用到。我们希望缓存中的数据尽可能被多次使用,并且缓存被充分铺满没有浪费;但容量小又限制它只能存一些常用的数据,尽可能减少替换数据的次数。
所以设计缓存的架构要满足以下三点要求:
- 缓存被充分利用,减少空间浪费
- 查询速度要快
- 减少缓存替换的次数
下面带着目标,看看现代常见的 CPU 缓存架构是怎么设计的:
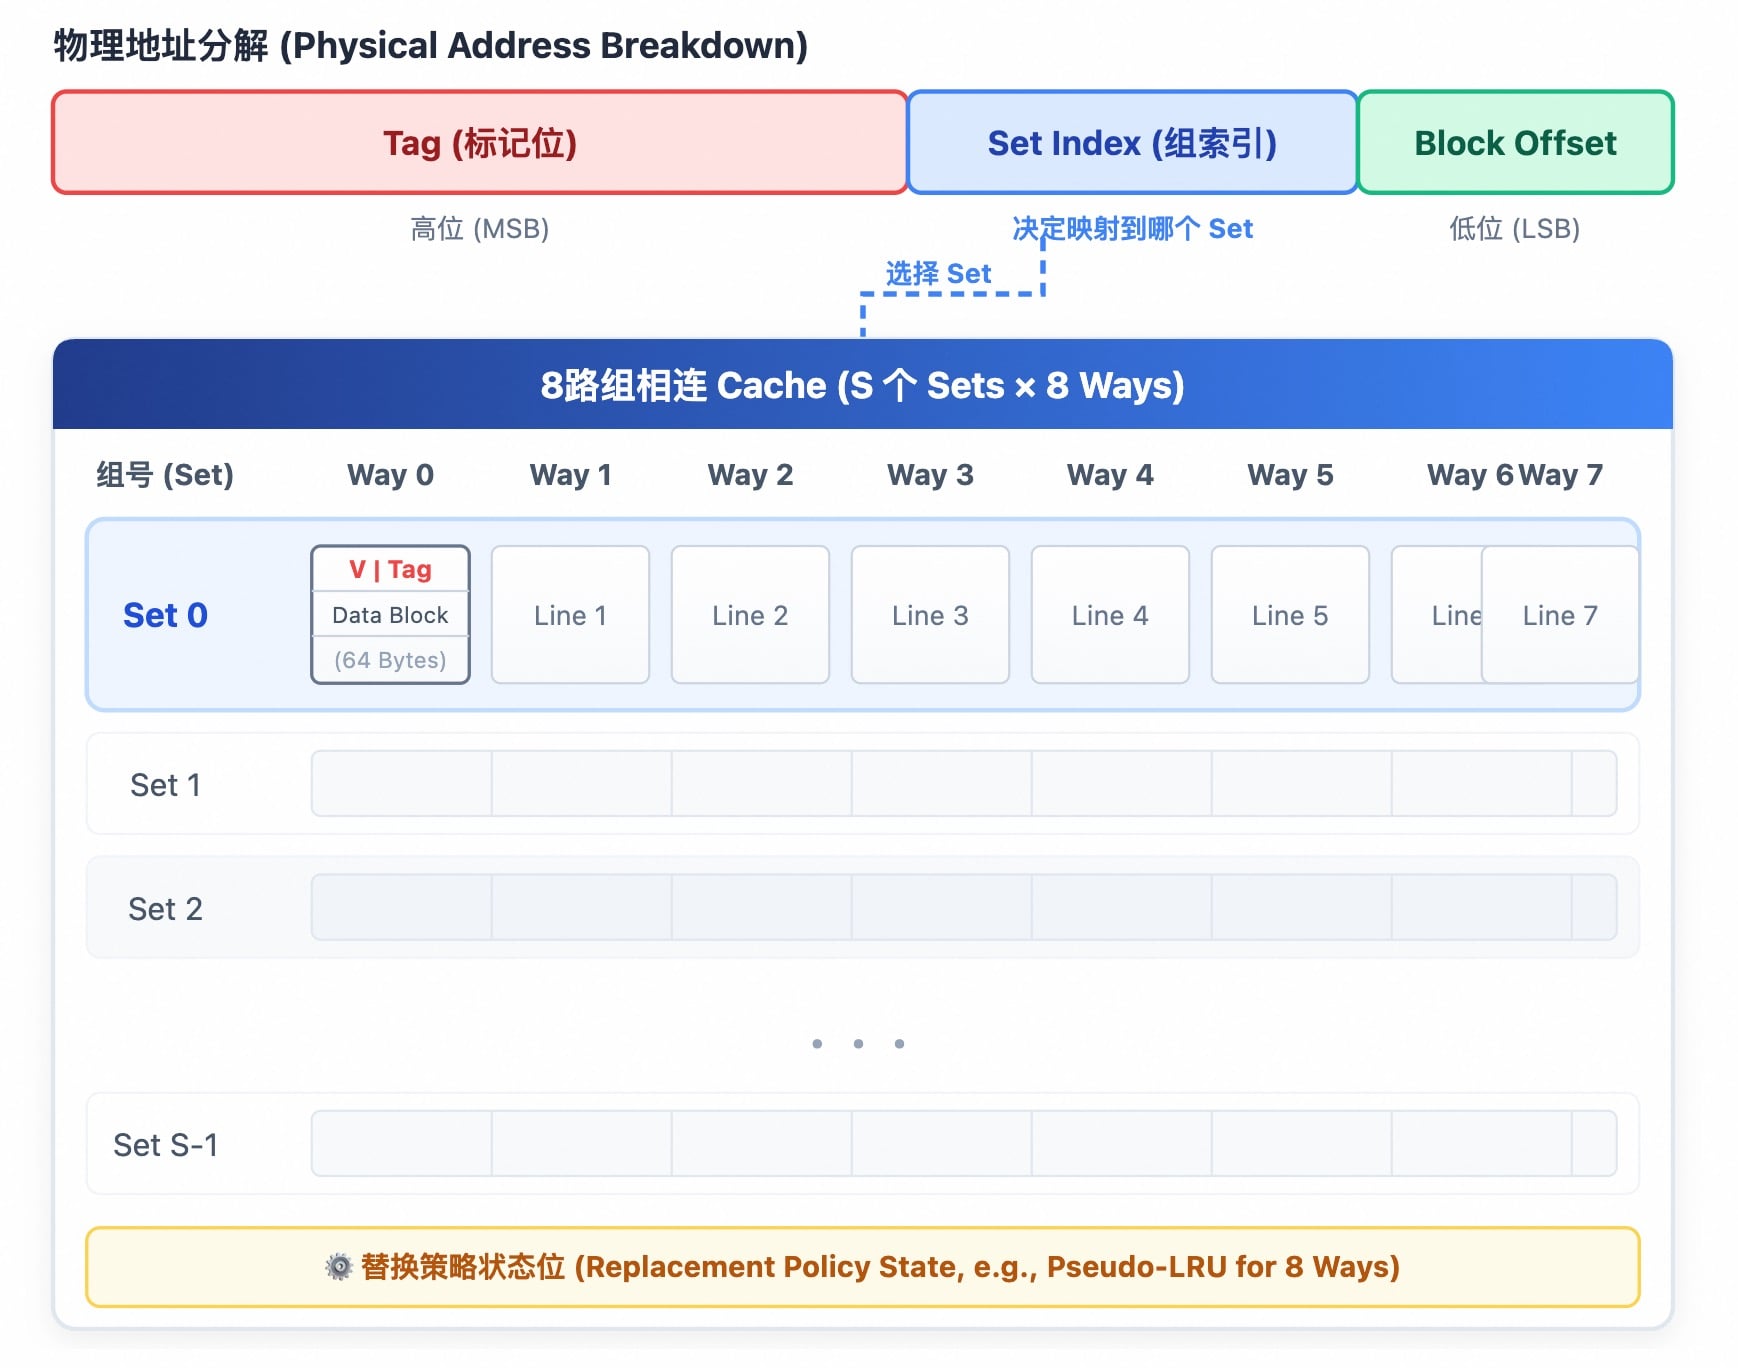
36 位地址被分成 [ 标签 Tag: 24 位 ][ 组索引 Index: 6 位 ][ 块内偏移 Offset: 6 位 ],对应 64 个缓存组,每个组有 8 路,每个缓存行 64B。
这串数字背后是一套完整的寻址逻辑。CPU 要访问某个内存地址时,把 36 位地址拆成三段,各司其职:
36 位内存地址:
┌──────────────────┬─────────────────┬─────────────────┐
│    Tag(24 位)   │  Index(6 位)   │  Offset(6 位) │
└──────────────────┴─────────────────┴─────────────────┘
  高位 → 标识数据是谁                    低位 → 定位字节位置
- Offset(块内偏移,6 位):缓存行是 64B = 2^6,用 6 位定位这 64 个字节里的具体哪一个字节,这是访问的最小粒度。
- Index(组索引,6 位):64 个缓存组 = 2^6,用 6 位决定这个内存地址会被映射到哪一个组。
- Tag(标签,24 位):剩下的高位。组里每个缓存行都记录了自己"装的是哪个内存块",Tag 就是用来比对的身份标识。
为什么这样拆?关键是 Index 和 Offset 只负责"定位位置",不参与"判断是谁"。判断一个数据是否在缓存里,只靠 Tag 比对。
组相联缓存如何定位数据
当 CPU 要读地址 A 时,流程如下:
- 取出
A的 Index(6 位),找到对应的缓存组(64 组之一)。 - 取出
A的 Tag(24 位),和这个组里 8 路缓存行的 Tag 并行比对。 - 如果某一路的 Tag 匹配,说明命中(Cache Hit),再用 Offset 从这行的 64 字节里取出目标字节。
- 如果 8 路的 Tag 都不匹配,就是未命中(Cache Miss),需要从下一级缓存或内存把整个 64 字节缓存行搬进来,替换掉组里某一路的数据。
这里有两个关键点:
- 并行比对:8 路是同时比的,硬件上是一个多路比较器,所以 8 路和 1 路的查找速度几乎一样,这也是组相联能比全相联快的原因。
- 按块搬运:哪怕只读 1 个字节,也会把包含它的整个 64 字节缓存行搬进来。这就是空间局部性的落地——旁边 63 个字节很可能马上被用到。
三种地址映射方式
前面说"一个内存地址映射到哪个组由 Index 决定",但具体能放到组里的哪一路,取决于映射策略。历史上有三种:
| 映射方式 | 内存块能放的位置 | 查找成本 | 冲突(替换) | 硬件复杂度 |
|---|---|---|---|---|
| 直接映射 | 固定的唯一一个缓存行 | 最低(只比一路) | 最高 | 最简单 |
| 全相联 | 任意缓存行 | 最高(要比所有行) | 最低 | 最复杂 |
| 组相联 | 固定组内的任意一路 | 中等 | 中等 | 折中 |
回到最初提的三个设计目标,能看清为什么主流最终选择组相联:
- 充分利用缓存、减少浪费:直接映射最差——两个内存块如果 Index 相同(比如地址相差 64KB 的倍数),会争抢同一个缓存行,即使缓存其他地方空着也用不上;全相联最好,组相联居中。
- 查询速度快:直接映射最好(只查一行),全相联最差(要查所有行,缓存越大越慢),组相联只需在一个组内查 8 路,成本可控。
- 减少替换次数:全相联最好,直接映射最差。
直接映射查询最快但冲突太多,全相联冲突最少但查找太慢、硬件复杂,组相联用"先按 Index 定位组、组内自由选择"的方式取了折中。所以现代 CPU 的 L1/L2/L3 基本都是组相联,只是路数不同(L1 常是 8 路,L3 可能 16 路甚至更多)。
为什么地址按 Tag / Index / Offset 这个顺序排
这个顺序不是随意定的,本质是高位 → 低位的对应:Tag 是高位、Index 是中位、Offset 是低位。每个字段的位置由它承担的职责和局部性原理共同决定,换位置会直接破坏缓存的命中率。
Offset 必须在最低位。 缓存行 64B = 2^6,行内字节偏移天然就是地址的最低 6 位(地址除以 64 的余数)。这是由"字节寻址 + 行大小是 2 的幂"决定的,物理上没得选。它服务空间局部性:相邻的地址(只有低位不同)落在同一个缓存行里,顺序访问时搬一次就能连续命中。
Index 必须放在中位,这是关键。 Index 决定数据落到哪个组。如果把它放到最高位,会出现灾难:连续的内存地址高位是相同的,于是整整一大段连续数据(比如一个大数组、顺序执行的代码)会全部映射到同一个组,互相挤占,而其他 63 个组空着没用。这正是设计目标里"充分利用缓存、减少冲突"的反面。
用前面的例子算一下:
- 正确的排法(Index 在第 6~11 位):地址 0~63 落在组 0,64~127 落在组 1……顺序访问的数据轮流铺到 64 个组上,冲突最少。
- 错误的排法(Index 换成最高的 6 位,即第 30~35 位):地址 0 到 2^30-1(整整 1GB 的连续内存)的 Index 全是 0,全部挤在组 0,剩下 63 个组闲置,冲突未命中会爆炸。
所以 Index 用的是"变化速度恰到好处"的那几位:既不能是最高位(变化太慢,连续数据挤在一个组),也不是最低位(那已经是 Offset 了)。它让顺序访问的数据在组间均匀摊开,最大化缓存利用率。个别缓存会用异或哈希等方式进一步打散 Index 以降低特定访问模式下的冲突,但主流仍是连续的中间位。
Tag 是剩下的高位。 组选好后,还要判断组里 8 路缓存行装的是不是要访问的那个内存块,Tag 就是这份"身份标识"。它放在高位,是因为地址里真正区分"不同内存块"的信息集中在高位。
总结成一句话:Offset 的位置是被硬件逼出来的,Index 的位置是刻意设计出来服务空间局部性的,Tag 是剩下用来比对身份的。一旦把 Index 挪到高位,连续访问会全部挤进同一组,缓存利用率断崖式下跌。
缓存未命中的代价与类型
未命中不是"再读一次内存"那么简单,它要按 Cache Miss Penalty(未命中代价)来算。内存访问一次 200~300 个周期,而 L1 命中只要几个周期,所以一次 L1 miss 可能让这条指令多等几百个周期。
按成因,miss 分三类:
- 强制未命中(Compulsory / Cold Miss):第一次访问某个数据,缓存里必然没有。任何缓存都无法避免,只能靠预取(prefetch)缓解。
- 容量未命中(Capacity Miss):工作集超过缓存容量,旧数据被换出去后又需要访问。加大缓存可以缓解。
- 冲突未命中(Conflict Miss):组相联/直接映射下,多个内存块映射到同一组互相挤占。增加路数(相联度)可以缓解。
面试里能区分这三种 miss 并说出缓解手段,是加分项。
缓存写入策略
读缓存讲完,写缓存更复杂:写数据时,缓存和内存两份数据可能不一致,需要策略约定。核心问题有两个:什么时候写内存、写未命中时要不要先加载。
写直达 vs 写回
- 写直达(Write-Through):每次写缓存的同时,同步写入内存。实现简单、一致性好,但每次写都要等内存,性能差。
- 写回(Write-Back):只写缓存,把这一行标记为 dirty(脏),等到这行被替换时再写回内存。性能好,但实现复杂,还要维护 dirty 位。
现代 CPU 普遍用写回,因为内存写太慢,频繁写直达会拖垮性能。
写分配 vs 写不分配
针对"写未命中"(要写的数据不在缓存里):
- 写分配(Write-Allocate):先把内存块加载进缓存,再写。利用空间局部性,后续读写更快。
- 写不分配(No-Write-Allocate):直接写内存,不加载进缓存。
常见组合是 写回 + 写分配:写 miss 时加载进缓存再写,标记 dirty,替换时写回。这是大多数 CPU 的默认行为。
多核下的缓存一致性
前面都假设只有一个核心。多核时代,每个核心有独立的 L1/L2,同一块内存可能同时被多个核心缓存。这时"缓存和内存一致"还不够,还得保证"各核心之间的缓存也一致"。
问题场景:核心 A 和核心 B 都缓存了变量 x = 0。A 把 x 改成 1(写回策略下,A 的 L1 里是 1,内存可能还是 0)。B 再去读 x,如果读自己的缓存会读到 0,这就错了。
解决这个问题的是缓存一致性协议(Cache Coherence Protocol),最经典的是 MESI。
MESI 协议
MESI 用四个状态标记每个缓存行,四个字母是状态的缩写:
| 状态 | 全称 | 含义 |
|---|---|---|
| M | Modified(已修改) | 本缓存行的数据被改过,与内存不一致,且只有本核心有最新副本 |
| E | Exclusive(独占) | 数据与内存一致,且只有本核心持有这份副本 |
| S | Shared(共享) | 数据与内存一致,多个核心都持有这份副本 |
| I | Invalid(无效) | 该缓存行失效,不能使用 |
核心行为:
- 读:本核心缓存行是 I(无效)时,需要从内存或其他核心加载。如果其他核心有 M 状态的最新副本,需要先拿到那份数据。
- 写:本核心要写一个 S(共享)状态的缓存行时,必须先让其他核心的副本失效(发 Invalidate 消息,把它们置为 I),再升级为自己的 M 状态。
- M 状态被读:其他核心要读 M 状态的数据时,持有 M 的核心要把数据写回内存(或直接转发给请求方),然后两者都变为 S。
MESI 保证了一个不变量:任意时刻,最多只有一个核心持有某个缓存行的 M 状态。这是多核程序正确性的基石。
为什么会有伪共享
MESI 的一致性粒度是缓存行(64 字节),不是单个变量。这带来一个隐蔽的性能问题:伪共享(False Sharing)。
看一个多线程计数器的例子:
// Java 示例
class Counter {
    volatile long a = 0;  // 线程 1 反复 a++
    volatile long b = 0;  // 线程 2 反复 b++
}
a 和 b 各占 8 字节,但它们在内存里紧挨着,落在同一个 64 字节缓存行里。线程 1 写 a 时,会把整行置为 M 并让线程 2 的缓存行失效;线程 2 写 b 时同样让线程 1 失效。两个线程逻辑上互不相关,却因为共享同一缓存行而反复互相失效,导致性能严重下降——这就是"伪"共享:没有真正的数据共享,却有共享的代价。
排查思路:多线程程序里,两个"看起来应该并行无冲突"的变量,如果频繁被不同线程写且性能异常,先怀疑是否落在同一缓存行。
解决办法是缓存行填充(Cache Line Padding):在变量之间填充无用字节,让它们各自独占一个缓存行:
class Counter {
    volatile long a = 0;
    long p1, p2, p3, p4, p5, p6, p7;  // 填充 56 字节,把 b 推到下一个缓存行
    volatile long b = 0;
}
Java 8 还提供了 @Contended 注解(需加 JVM 参数 -XX:-RestrictContended),由 JVM 自动完成填充;C/C++ 里用 alignas(64) 或手写填充结构体。
如何写出缓存友好的代码
理解缓存机制后,日常编码有几个可以落地的小技巧,核心都是"顺着局部性原理写":
- 顺序访问数组,别随机跳。遍历
arr[i]时,访问过的缓存行里 63 字节是"白送"的,顺序遍历能最大化命中率;随机访问、跳跃访问会频繁 miss。 - 二维数组按行优先遍历。内存里二维数组是按行存储的,
arr[i][j]的遍历应当让i在外层、j在内层,这样访问的内存地址是连续的;反过来列优先会跨行跳跃,miss 率高。
// ✅ 行优先:内存连续,缓存友好
for (int i = 0; i < N; i++)
    for (int j = 0; j < M; j++)
        sum += a[i][j];

// ❌ 列优先:每次跳一整行,miss 率高
for (int j = 0; j < M; j++)
    for (int i = 0; i < N; i++)
        sum += a[i][j];
- 把频繁访问的热字段放在一起。结构体里如果只有少数字段被高频访问,把它们排在一起,能提高缓存行利用率,减少无谓的搬运。
- 多线程避免伪共享。并发写不同变量时,注意它们是否落在同一缓存行,必要时做缓存行填充。
- 优先用连续的内存结构。链表相对数组缓存不友好,因为节点分散在堆里,遍历链表就是一次次随机跳。对性能敏感的场景,数组或紧凑的结构往往比链表快。
这些技巧在普通业务代码里收益不大(瓶颈通常不在这),但在高性能计算、游戏引擎、数据库、网络库等场景是实打实的优化手段。
面试高频追问
最后把面试里围绕 CPU cache 的高频追问串一遍:
Q1:为什么 CPU 需要多级缓存,而不是一个超大缓存? 容量与速度的矛盾。越大的缓存查找越慢(全相联要比较的行数越多;即使组相联,大缓存也意味着更长的延迟和更高的成本)。分级让 L1 满足"快"、L3 满足"大",各自服务不同的访问模式。
Q2:缓存行为什么是 64 字节? 空间局部性的权衡。太小则无法利用空间局部性,还要更多 Tag 开销;太大则搬运成本高、浪费带宽,且同一行内容易引发伪共享。64 字节是长期工程实践沉淀下来的平衡点。
Q3:为什么写回策略比写直达更常用? 内存写延迟高(200+ 周期),写直达每次写都要等内存,性能差。写回把写操作"延迟"到替换时批量处理,配合 dirty 位,是性能优先的选择。代价是实现复杂,且断电可能丢数据,所以需要缓存的刷新机制。
Q4:多线程里的 volatile 和 CPU 缓存是什么关系?
volatile 保证可见性和禁止重排,是语言层面的保证;底层靠内存屏障指令 + 缓存一致性协议(MESI)落地。写 volatile 变量后,对应的缓存行会被刷到内存并失效其他核心的副本,从而让其他线程读到新值。二者是"语言层保证"和"硬件层机制"的配合关系。
Q5:伪共享怎么定位和解决?
定位靠 perf 等工具观察 cache miss,或直接看代码里"不同线程高频写相邻变量"。解决靠缓存行填充或 @Contended。
总结
- 缓存的本质是把高频数据放到离 CPU 更近的地方,靠局部性原理(时间 + 空间)获得高命中率。
- 三级缓存(L1/L2 独享、L3 共享)是容量与速度权衡的结果。
- 地址被拆成 Tag / Index / Offset 三段,分别负责"是谁 / 在哪个组 / 第几个字节";组相联映射是查找速度和冲突率之间的折中。
- 写入有写直达 vs 写回、写分配 vs 写不分配两组策略,现代 CPU 默认写回 + 写分配。
- 多核下靠 MESI 一致性协议保证各核心缓存一致,其副作用是伪共享——不同变量落在同一缓存行会互相失效拖慢性能。
- 缓存友好代码的核心是顺着局部性写:顺序访问、行优先遍历、热字段聚合、避免伪共享。
CPU cache 是一层经常被忽略的硬件机制,但理解它能解释很多"为什么这么写更快"的现象。对前端工程师来说,它不直接出现在日常业务里,却是往操作系统、并发、高性能计算这些方向继续深入的必备地基。