前端渲染卡顿优化实践
一、概要
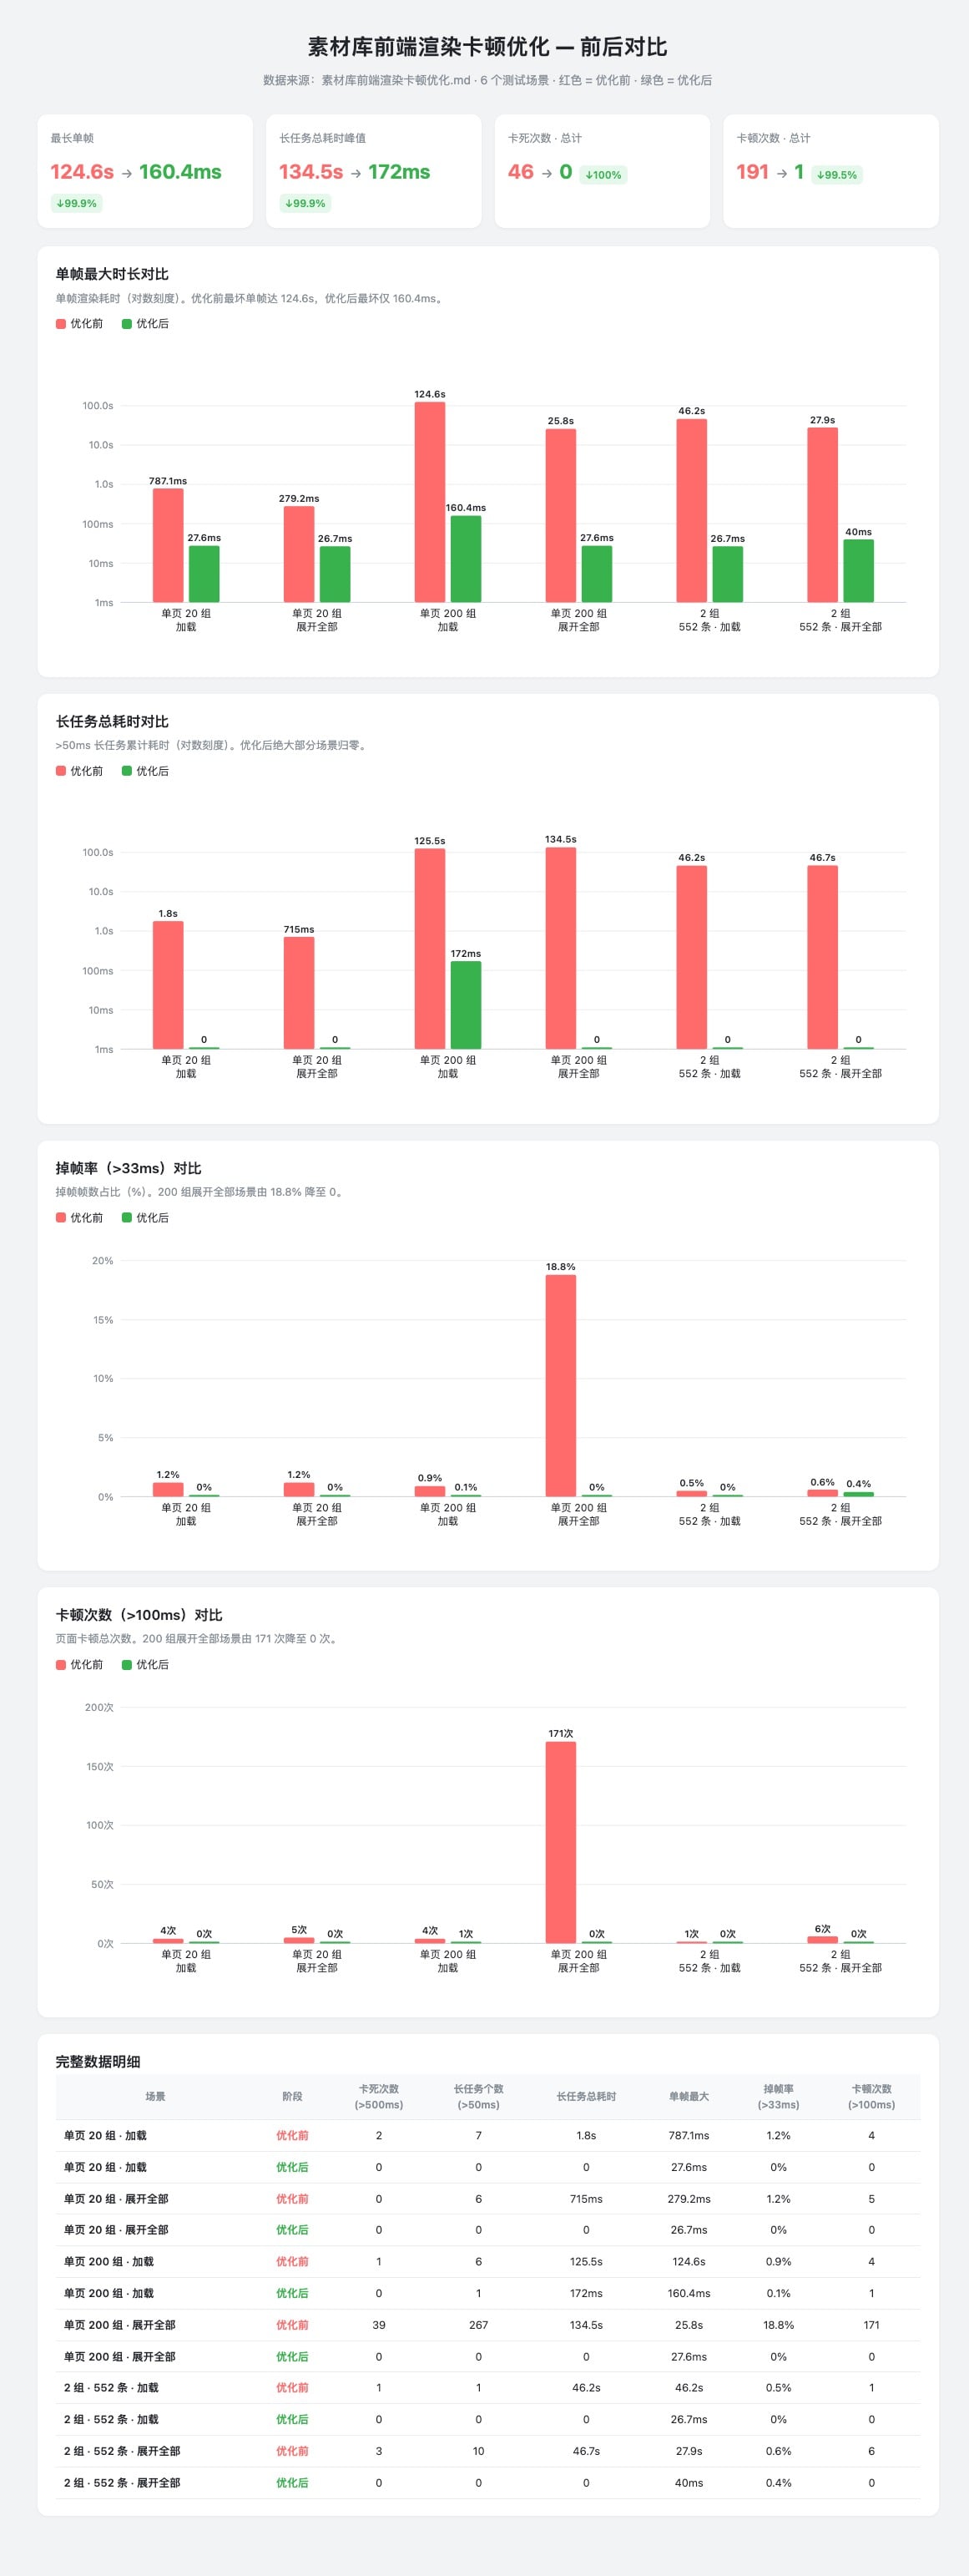
作者通过实践可视性懒挂载思想、分帧处理思想,降低页面渲染节点数量,修复不规范代码引发框架性能问题,从而解决页面卡死崩溃、交互响应慢等性能问题,实现页面 0 卡死、0 卡顿,极大提升用户体验。
二、背景
平台素材列表出现页面加载慢、卡死、崩溃等严重影响体验的问题。本文记录解决此问题的思路、结果和思考。
三、解决过程
懒挂载未展开的表格
我排查下来发现,在用户这个筛选条件下,接口响应 2.3s 左右,接口返回 2 个素材组,总计 552 条视频数据。在此之前,没有如此大的数据,因此并未暴露出页面的性能缺陷。
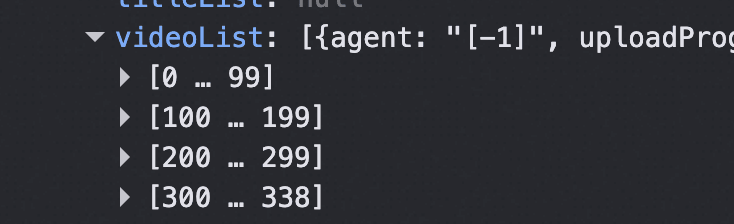
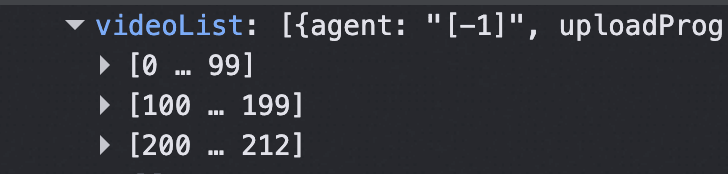
那么我推测是因为大量数据同时渲染,才将页面卡崩。
于是我查看页面的结构,排查主要卡点,发现素材组列表做了分页,单页 20 条,最多 100 条,这个数据量不至于把页面卡崩溃。重点是被折叠在素材组下的素材列表,虽然没展开,但是实际也渲染出来了,以上面查询条件为例,2 个素材组就有 552 条数据,这个数量级才可能把页面卡崩溃。
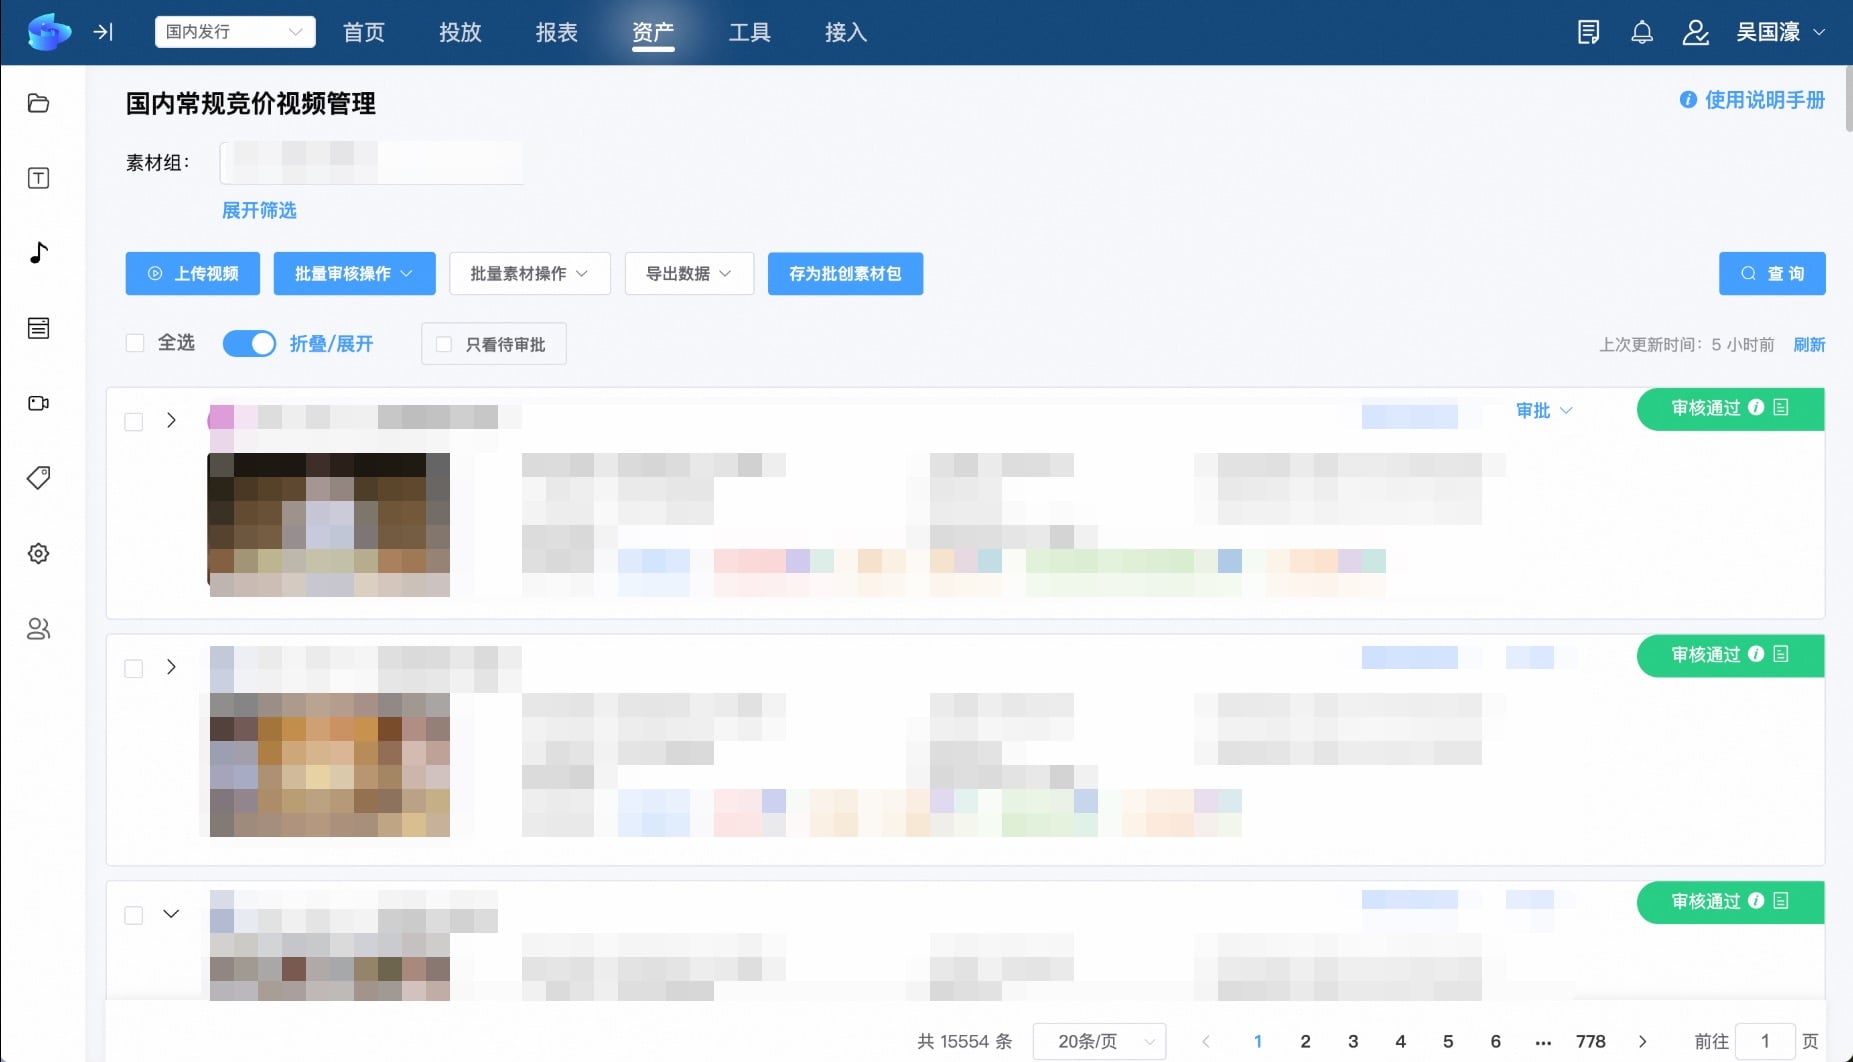
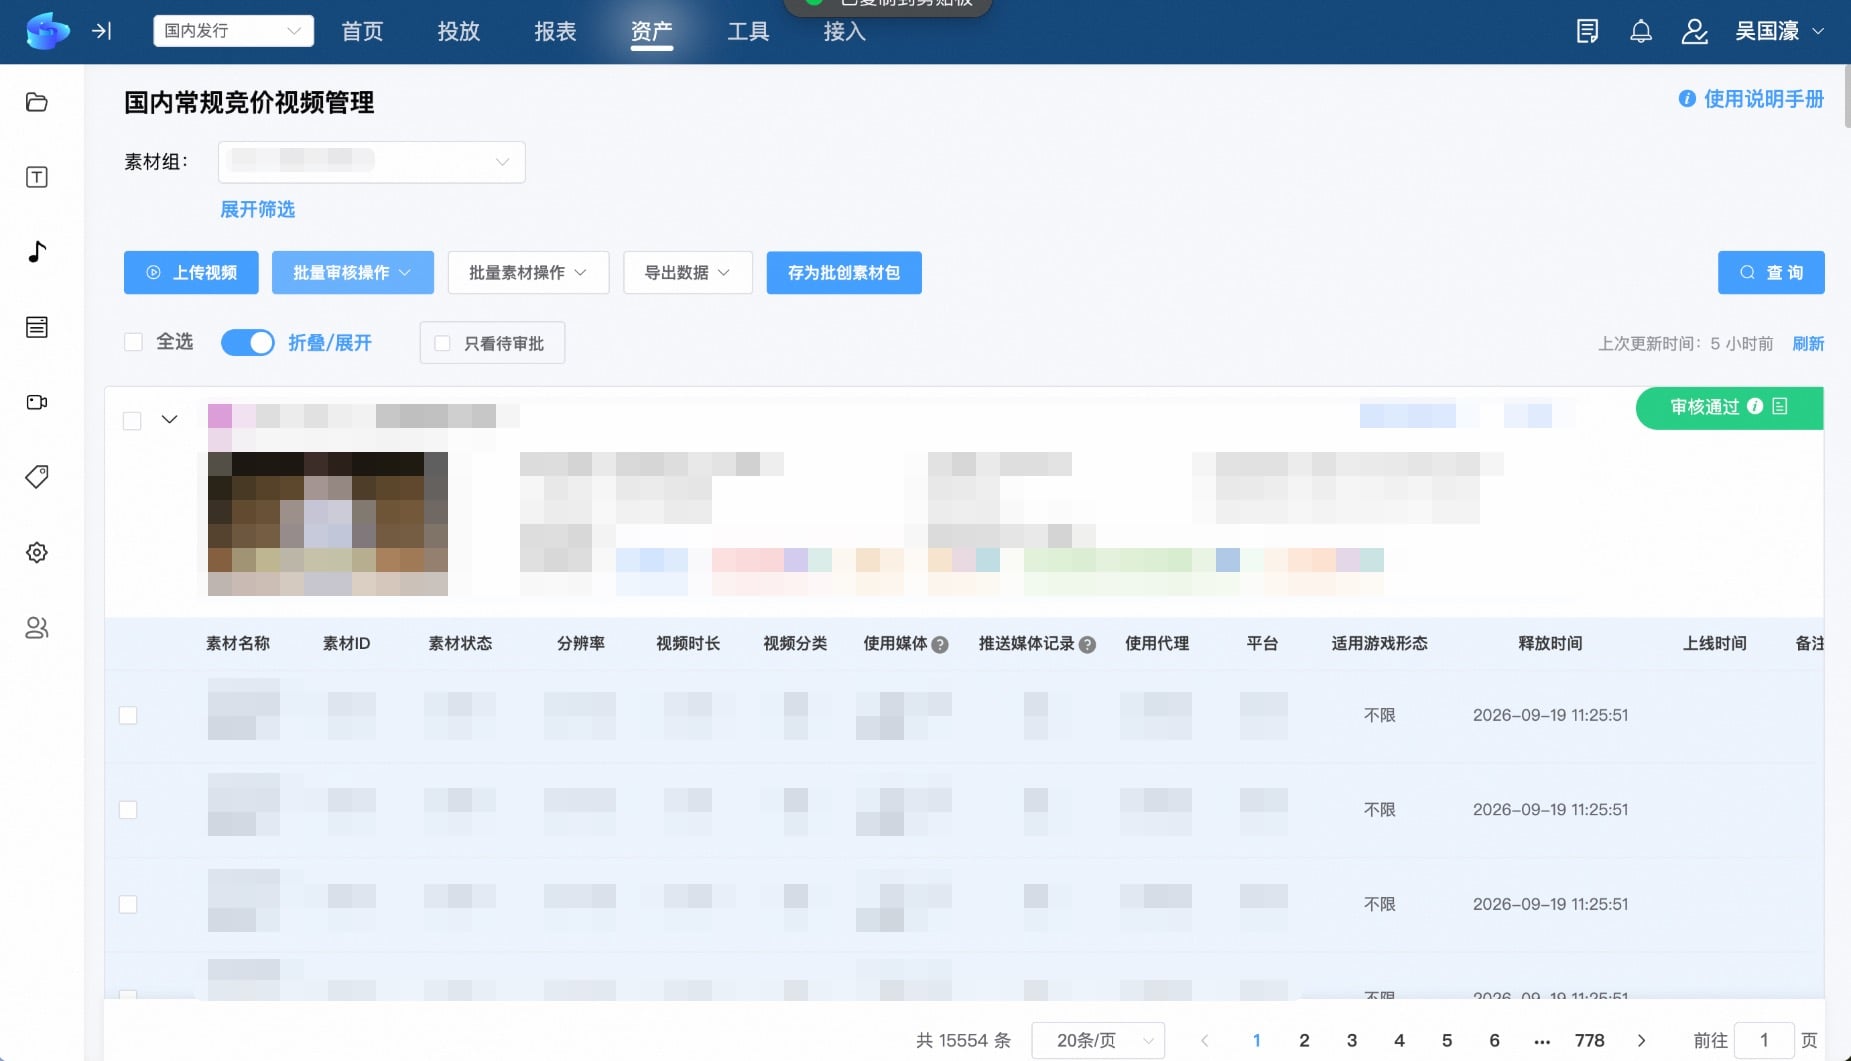
这里我想到懒挂载的思路,尝试把未展开的素材列表砍掉暂不渲染,等用户点击展开再渲染。优化之后,除了要等待接口响应的时间,渲染是秒出。
自测时才发现不对,点击展开按钮,卡得什么都操作不了,等了近 2 分钟,列表展开了。
性能埋点&控制变量 排查问题
上面的方案只是将渲染素材列表的时机从首屏转移到点击展开按钮,治标不治本。于是我先在代码里加上性能埋点,收集单个组展开的延迟时间,也可作为后续优化的数据基线。
本文排查阶段用的是
console.time和后面的[vm-perf]日志这类临时埋点。后来我把采集逻辑沉淀成一个浏览器层面的通用卡顿监测工具(基于 PerformanceObserver / rAF,跨 Vue2/Vue3/React),能统一采集卡死、长任务、掉帧三类数据,引入时机、使用方式和扩展方法见《前端卡顿监测工具 perfMonitor 使用与扩展》。
console.time(`[点击展开]`);
console.timeEnd(`[点击展开]`);
日志:
[点击展开]:1116362.52807617188ms
再一次记录时间 116362ms = 116.3s,非常卡啊。我点击展开的素材列表有 339 条数据,如果是纯文字的普通表格,339 条数据也不应该卡这么久,我推测是每个单元格的渲染过于复杂了,所以先用控制变量法,先把所有表格列的自定义渲染注释掉,只保留最原始的渲染,再一次收集展开耗时。
日志:
[点击展开]: 222.56787109375 ms
这一次 222.5ms 减少了 99.8% 的耗时,后续就是一列一列放开,观察耗时情况;没想到放开的第一列就出问题。
日志:
[点击展开]: 48543.9619140625 ms
日志显示 48.5s 左右,占了 42%左右的耗时,这一列用一个formatter 函数作为单元格内容,功能是把 id 数组翻译成中文然后拼接。这里是直接在模板里调用函数,即是每一个用到的单元格都会调用一次,我查阅了代码一共有 11 列会走这段逻辑: 339 * 11 = 3729 次。
推测是因为 Vue 模板中直接调用函数次数太多,累计耗时才会那么长。所以我考虑使用虚拟列表,减少渲染的行数,从而减少调用次数,同时也能减少挂载的组件。再次测试:
日志:[点击展开]: 221.802978515625 ms
延迟 221ms 勉强可以接受,我把所有列放开,
日志:[点击展开]: 235.1259765625 ms
测得数据是 235ms 左右,变化不大,事情似乎好起来了...
禁止循环读 computed
但是,每次滚动时,白屏和卡顿很严重。再次观察日志,发现一个规律,每调用 7 次,会有一次耗时比较长。加上 prop 日志之后,发现是媒体这一列,作用是把媒体 id 数组翻译成中文然后拼接,其他列也做了类似的事情,但是这一列数据比较大,有 260 个。
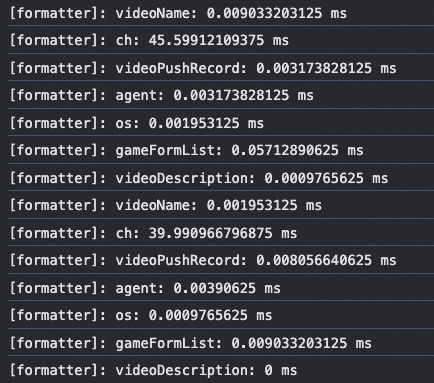
我意识到刚才忽略了一个细节,正常情况下遍历一个长度 260 的数组,执行查表、过滤、拼接,应该是微妙级别的,40ms 左右的耗时是不正常的,于是我做了一个实验,长度 1000 的数组也才耗费 0.05ms 左右,相差 800 倍。
function main(){
  const map = {};
  for (let i = 0; i < 1000; i++) {
    map[i] = i;
  }

  const arr = new Array(1000).fill(0);
  console.time('1000次循环耗时:');
  arr.map(item => map[item]).filter(Boolean).join(',');
  console.timeEnd('1000次循环耗时:');
}
main(); // 1000次循环耗时:: 0.047119140625 ms
通过 performance 录制发现,存在 560ms 的长任务,并且火焰图显示 computedGetter 函数被多次调用。
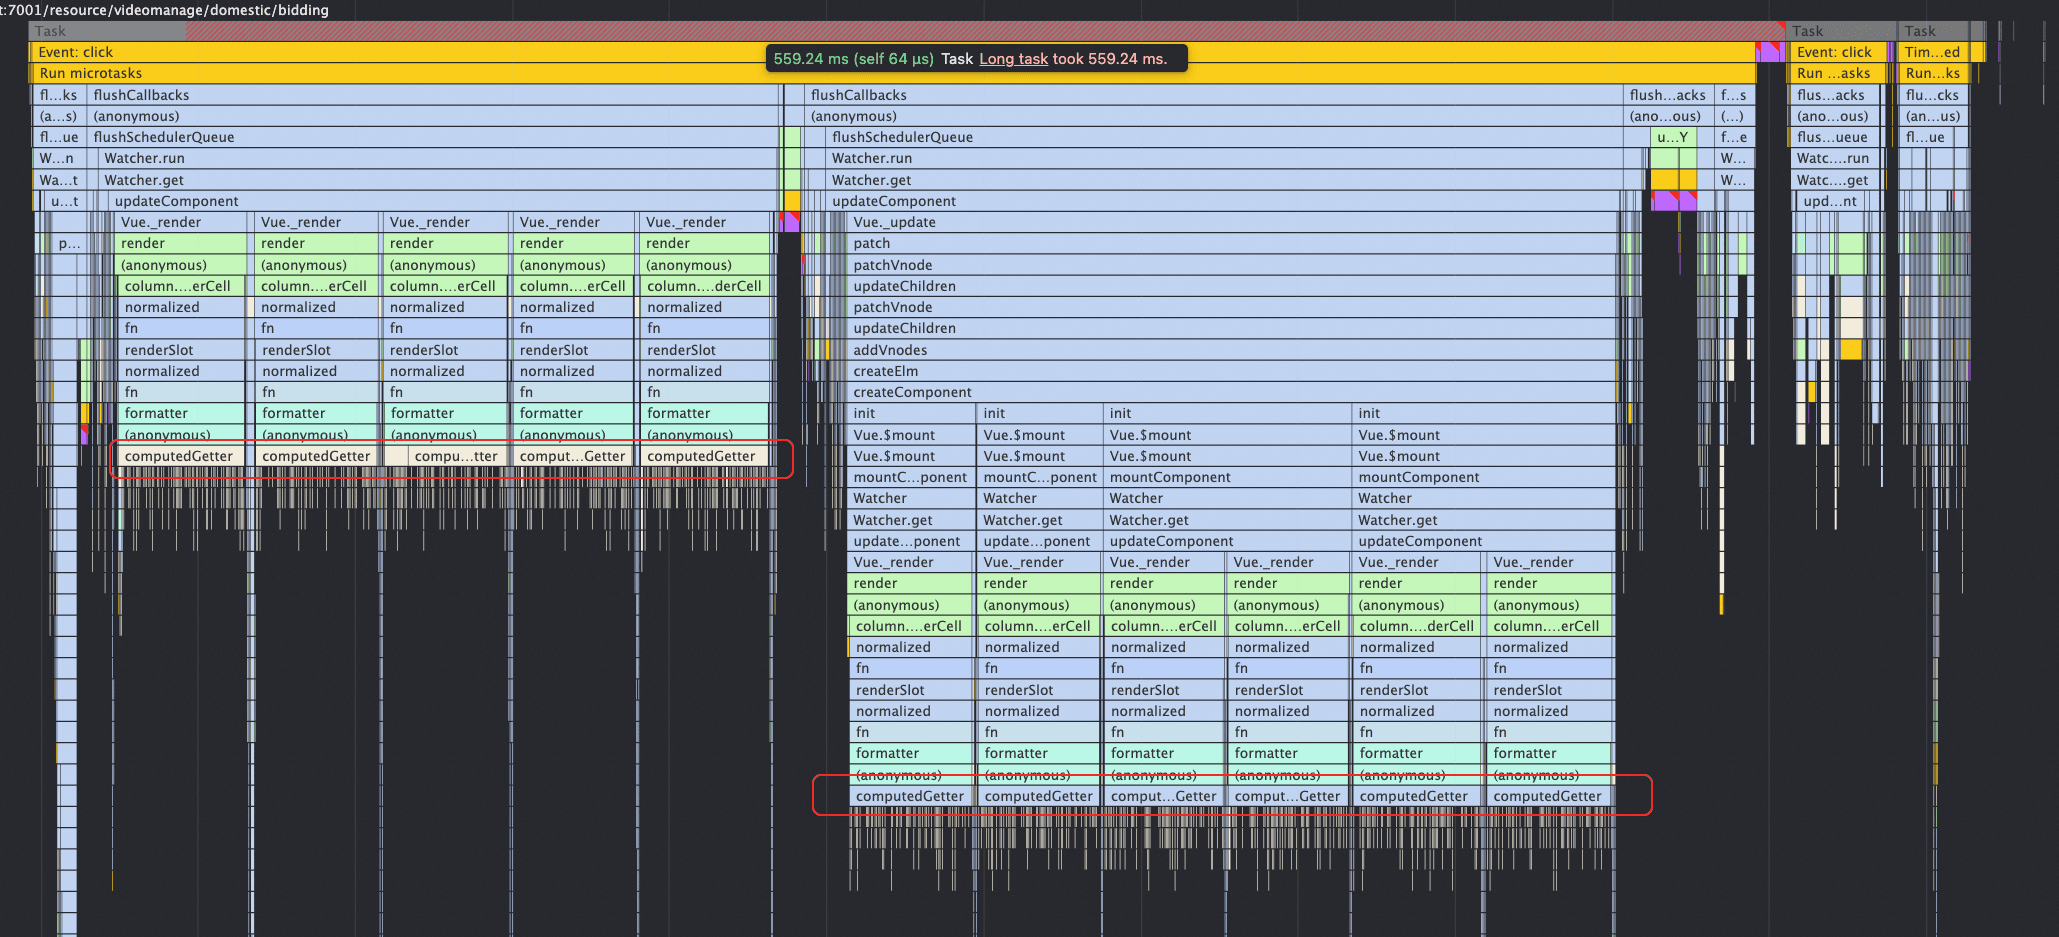
查看代码发现:查表的方式是在 .map 回调里逐项访问 this.ChListMap 这个 computed。
this.ChListMap 是 computed(fromPairs(this.ChList, ...))。在 render 期间每访问一次,Vue2 内部会:
- 调用 computedGetter 函数;
- 因为有
Dep.target,触发watcher.depend(),把这个 computed 依赖的所有 dep 重新订阅一遍。
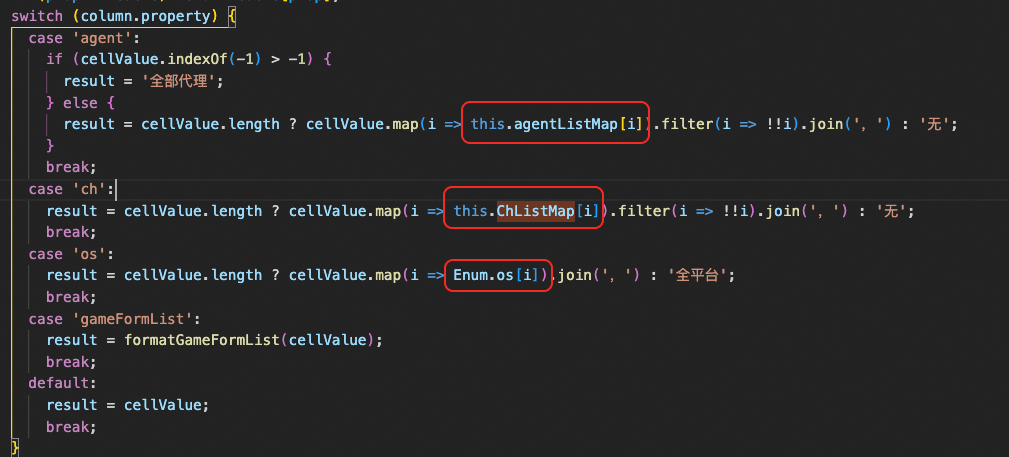
表面是触发 260 次读ChListMap,实际是为ChListMap触发 260 次依赖订阅。
解决方案:只需将 ChListMap 表提到循环外用一个变量保存,再读,就不会频繁触发 getter 了
日志:[点击展开]: 43.385986328125 ms
再次查看日志,耗时来到 43ms,而且滚动没有那么卡了。
懒挂载未在可视窗口的表格
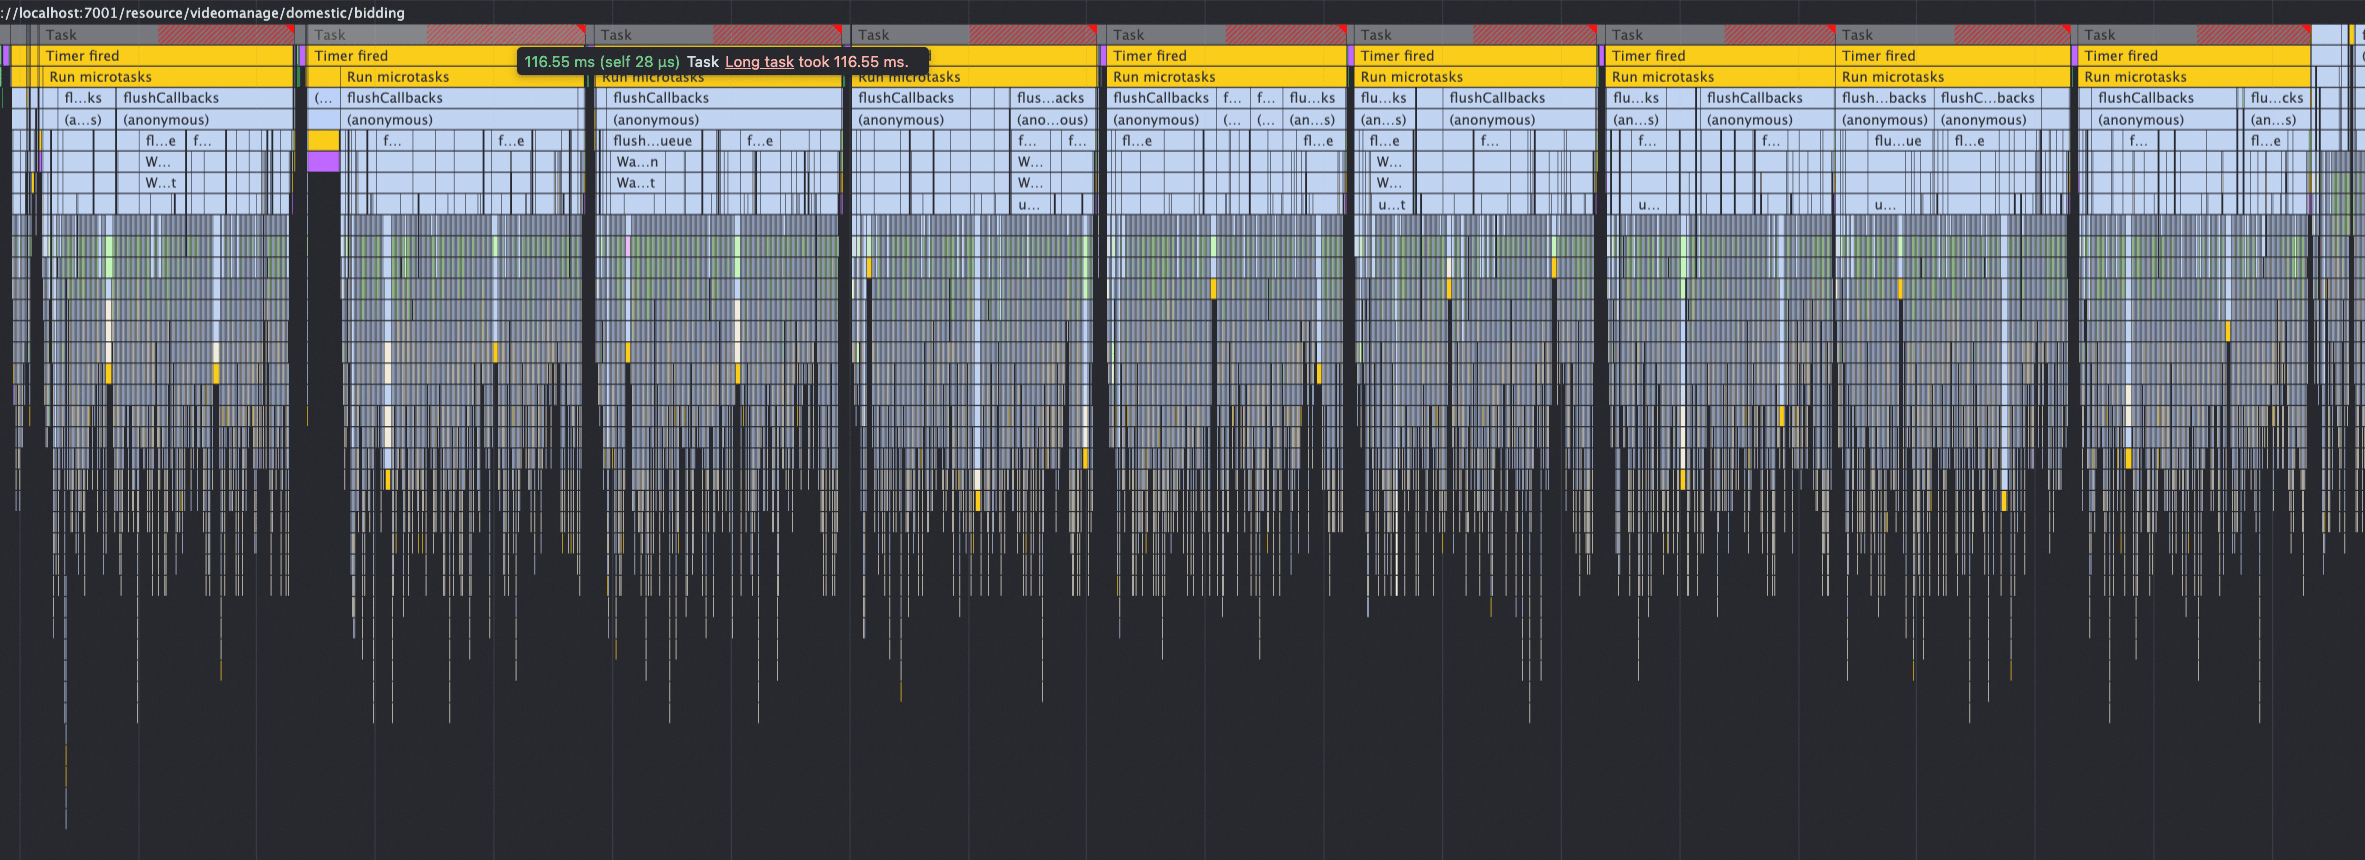
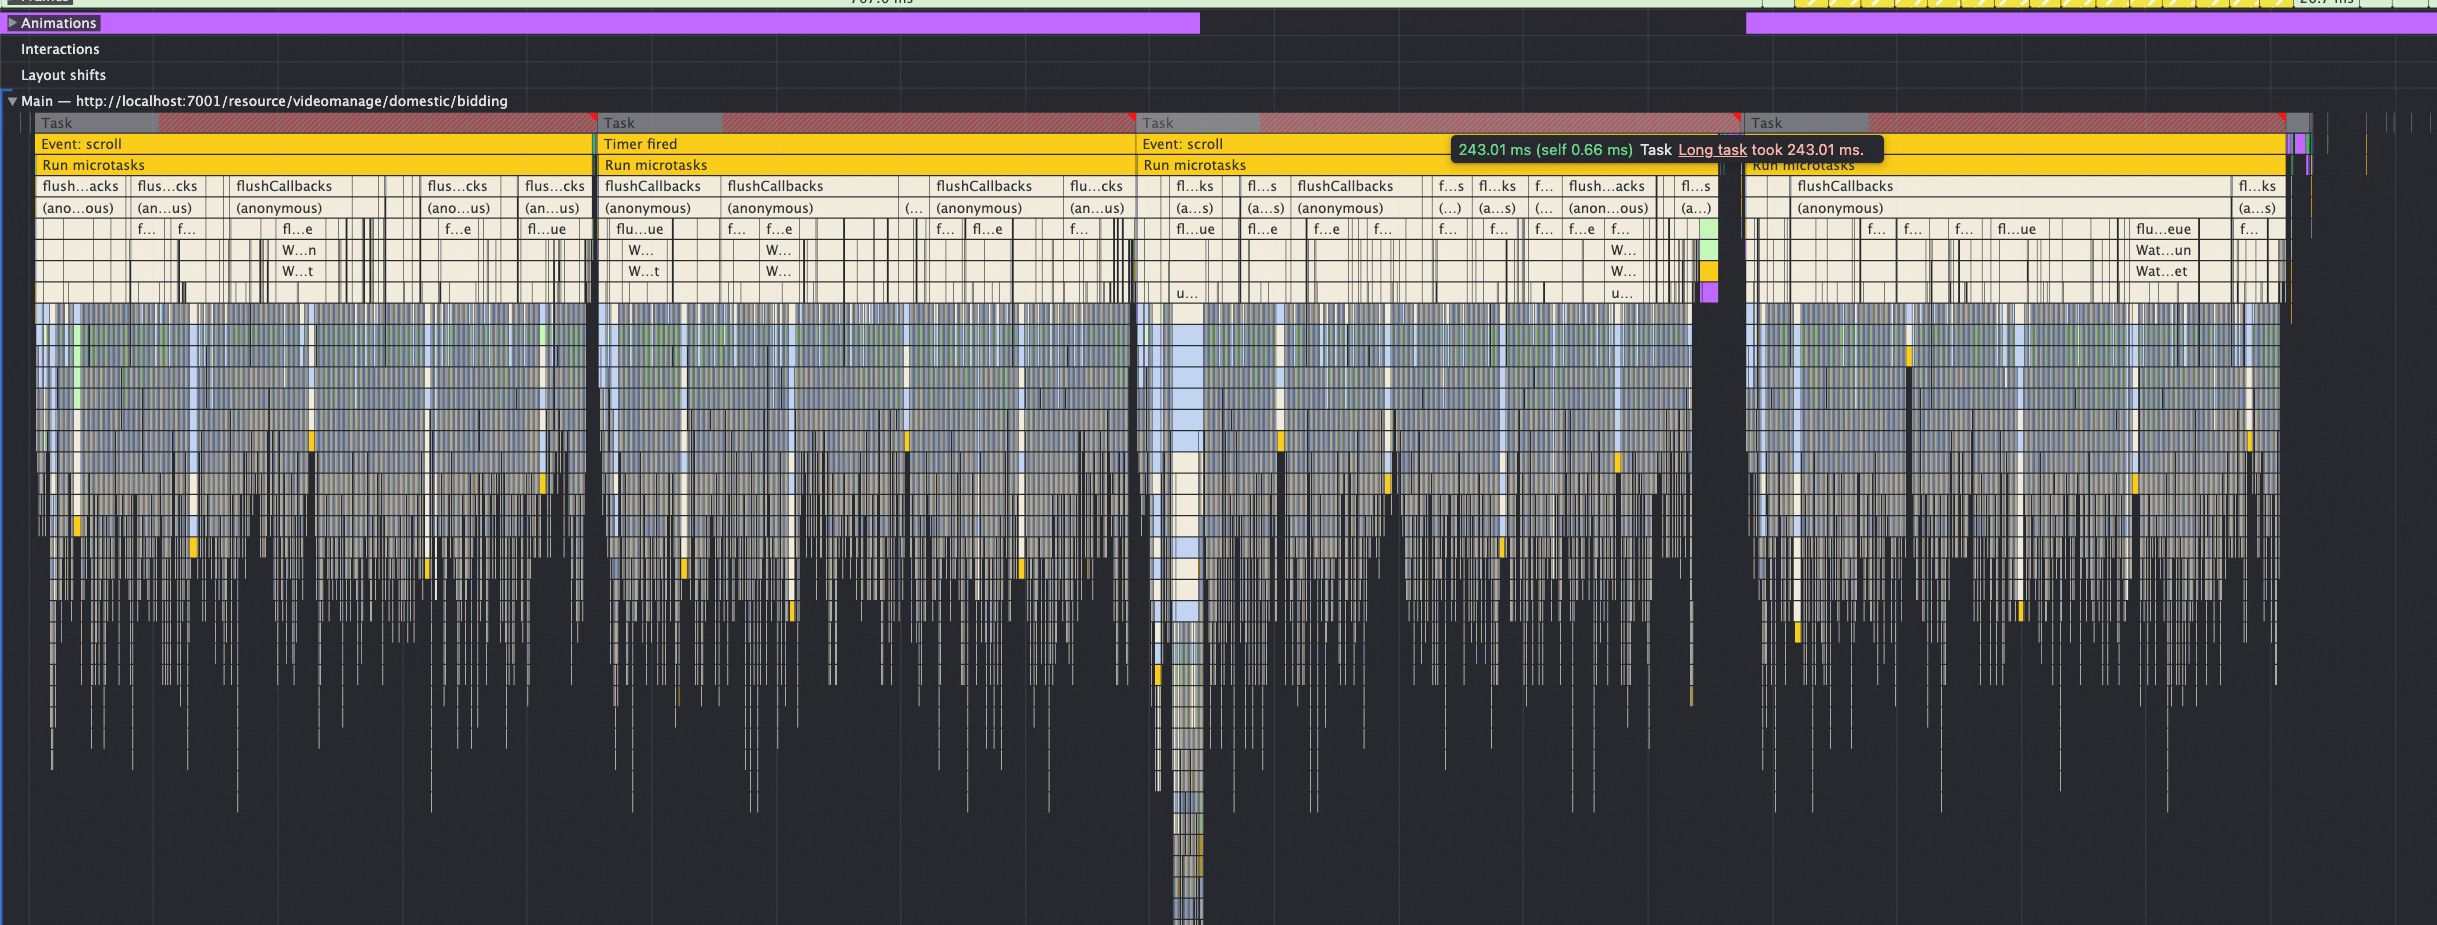
自测进入下一阶段,上面是单个组展开 43ms,现在测试“全部展开”,所有的行都会展开并渲染表格,使用 performance 录制可以看到有十几个 110ms 左右的长任务,这是因为它在一次 Vue flush 里把所有组的 <el-table>(每组约 20 列 × 5 行,大量 el-tooltip/el-popover 实例)全部挂载。屏幕里只看得到 1–2 个组,其余十几个表格都是白白渲染的离屏表格,每个挂载就是一个 ~110ms 长任务。
考虑从两个维度进行优化:
-
降低单表挂载成本
-
减少长任务数量
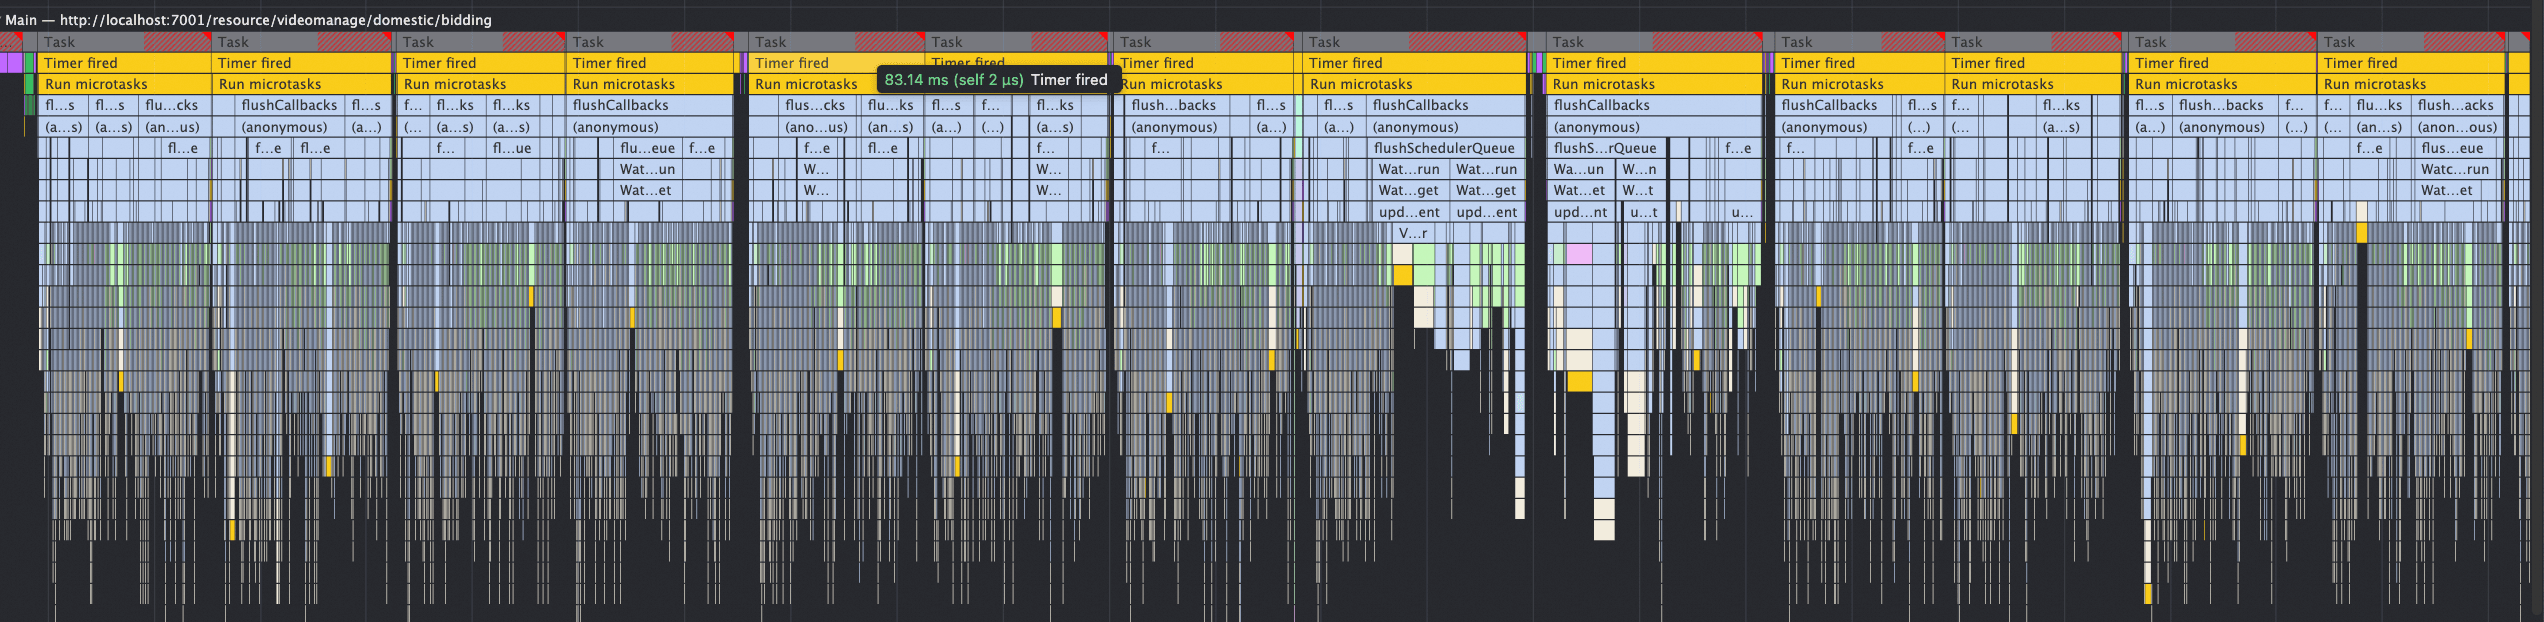
降低单表挂载成本 减少每个 cell 的组件实例:将 el-tooltip、 el-popover 组件改为 hover 时才创建,延时从 110ms 降到 83ms 左右。
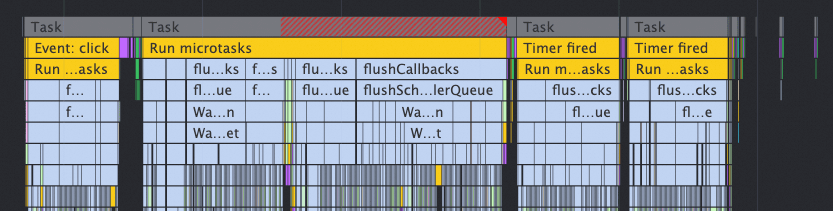
上面是缩减单个表格的挂载成本,但是多个一起挂载还是有点卡顿,再次考虑用懒挂载,只挂载在可视窗口内的表格,其他的等滚动快到可视区才挂载,十几个长任务直接锐减到 4 个,体感好了不少,能够较为流畅的响应全部展开
分帧渐进挂载
经过上面优化之后,长任务其实还存在,特别是在快速滚动时,会有白屏 500ms 左右,是因为滚动太快,表格还没来得及挂载出来。
我想既然是来不及渲染一屏 5 组数据,那就一组一组渲染,一行一行渲染,每一个素材组逐帧挂载,每一组内的表格行也逐帧挂载。
首帧只渲染第一组的 3 行数据,其他数据分摊到后续帧逐步补到目标窗口,这样用户看起来就像是一点点加载出来,体验会更好一点,而不是白屏一小会再一起加载出来。
改造完成发现在单页 20 条场景下,体验良好,数据也是一行行加载出来。
缩小状态更新影响的组件范围
但是,一旦把单页切换到 200 组,点击全部展开,就卡得没法看,查看 performance 5 个 300ms 的长任务,1 个 550ms 的长任务。并且火焰图显示 updateComponent 函数被多次调用。

一开始,我推测是切片太碎,导致大量任务堆积引发的,于是再次加性能埋点,判断原因,着重看是因为挂载本身耗时太长,还是因为任务堆积。
| 日志 | 含义 | 用来判断 |
|---|---|---|
observe total=200 unrenderedObserved=N | expand-all 时进入预挂载区(视口+800px)的未渲染组数 | 确认懒渲染范围,N 应该远小于 200 |
intersect +hit queueLen=M | 每次 IO 回调入队几组、队列积压多少 | 看是否一次排了很多组 |
mount gid=X patched=Yms rows=3 | 单组挂载成本(sync + Vue patch,nextTick 后测) | 若 Y≈400 → 长任务=挂载本身,mount 主导 |
progress gid tick#n a->b set=Zms / DONE / GIVEUP | 每次 +3 行的 $set 同步耗时、总 tick 数 | 若 set 小但帧仍长、tick 多 → patch 在微任务里堆积,progress 主导 |
归因判读规则
-
mount patched≈ 400ms 且 progress tick 少/小 → 主杠杆是挂载数量/单价(降 rootMargin、只挂视口内、或给 el-table 降单价),调步长无用。 -
mount patched小、但帧长且 tick 多 → 才是分太碎,改粗步长或限并发 progress。
注意一点:progress 的 el-table patch 发生在 $set 之后的微任务里,set=Zms 只测到同步部分;要看 patch 真实耗时,把火焰图里该 rAF task 的总宽减去 set 即可,或直接看 DONE total。
[vm-perf] observe total=20 unrenderedObserved=20
[vm-perf] intersect +2 queueLen=2
[vm-perf] mount gid=136905 patched=50.8ms rows=2
[vm-perf] mount gid=136875 patched=45.3ms rows=2
[vm-perf] progress gid=136905 DONE ticks=0 final=2 total=64.8ms
[vm-perf] progress gid=136875 DONE ticks=0 final=2 total=88.4ms
分析日志:
-
mount patched≈45-50ms:单组挂载本身不贵,不是 400ms 长任务的来源。 -
progress DONE ticks=0 final=2:virtual-scroll 上报窗口=2 行,和首帧 2 行相同,渐进补行一次都没执行。说明对小素材组,row-progressive 目前是空转的。 -
unrenderedObserved=20 / intersect +2:懒渲染生效
[vm-perf] expandAll parentPatched=266.3ms groups=200
[vm-perf] observe total=200 unrenderedObserved=200
[vm-perf] intersect +2 queueLen=2
[vm-perf] mount gid=136905 patched=281.1ms rows=2
[vm-perf] mount gid=136875 patched=275.8ms rows=2
[vm-perf] progress gid=136905 DONE ticks=0 final=2 total=300.0ms
[vm-perf] progress gid=136875 DONE ticks=0 final=2 total=282.8ms
分析日志:
expandAll parentPatched=266ms:unFoldList变化 → 父模板整表 patch。mount patched=281ms / 276ms:同样的两组、同样 rows=2,20 组时只要 50ms,200 组要 280ms。成本随"总组数"线性放大,而表格本身行数没变 → 多的 230ms 是父级整表 diff,不是 el-table。因为__rendered、__virtualList都在父模板里被读(v-if/:data),改它们就重渲染整个父组件。updateComponent最热 = 父列表组件被反复 updateComponent。progress ticks=0:渐进补行没贡献,排除。
所以 200 组下的长任务既不是单组挂载(50ms)也不是 progress(空转),而是某个随组数放大的同步 Vue 渲染。最大嫌疑是 expand-all 时父列表的整体 re-render(unFoldList 变化 → unFoldSet → 200 个 collapse 项 v-show/placeholder 一起 patch),这正好和 updateComponent 最热吻合。1 次 expandAll 父 patch + 若干次挂载父 patch(profiling 下再放大)。分帧/调步长都救不了,因为每一"帧"的工作单元本身就是一次 200 项整表 patch。
解决方案:把素材组 item 抽成子组件 GroupItem.vue,让 __rendered/__virtualList/__virtualWindow 只在子组件模板里被读。这样:
- 单组挂载只重渲染该子组件 → 回到 ~50ms 且不随总组数放大;
- 父级 v-for 变成 200 个轻量组件 vnode 的 diff,不再 diff 200 棵内联子树。
[vm-perf] expandAll parentPatched=20.0ms groups=200
[vm-perf] observe total=200 unrenderedObserved=200
[vm-perf] intersect +2 queueLen=2
[vm-perf] mount gid=136905 patched=31.8ms rows=2
[vm-perf] mount gid=136875 patched=22.9ms rows=2
[vm-perf] progress gid=136905 DONE ticks=0 final=2 total=42.3ms
[vm-perf] progress gid=136875 DONE ticks=0 final=2 total=21.6ms
expandAll parentPatched 266→20ms,mount patched 281→23~32ms,挂载隔离与父级 diff 瘦身都生效。
现在触发全部展开会导致 200 个子组件因 expanded prop 变化各自 re-render,可以把unFoldSet 驱动的 v-show/open class 下沉为子组件 prop ,并通过命令式同步,直接写 DOM(class + display),跳过 re-render
this.$el.classList.toggle('open', this._expanded);
list.style.display = this._expanded ? '' : 'none';
[vm-perf] expandAll parentPatched=13.5ms groups=200
[vm-perf] observe total=200 unrenderedObserved=200
[vm-perf] intersect +2 queueLen=2
[vm-perf] mount gid=136905 patched=63.6ms rows=2
[vm-perf] mount gid=136875 patched=31.5ms rows=2
[vm-perf] progress gid=136905 DONE ticks=0 final=2 total=70.8ms
[vm-perf] progress gid=136875 DONE ticks=0 final=2 total=20.9ms
expandAll parentPatched 与 200 子 render 消失,expand-all 只剩 IO + 视口内挂载。
最终结果,长任务消失了,取而代之的是十几毫秒的短任务。
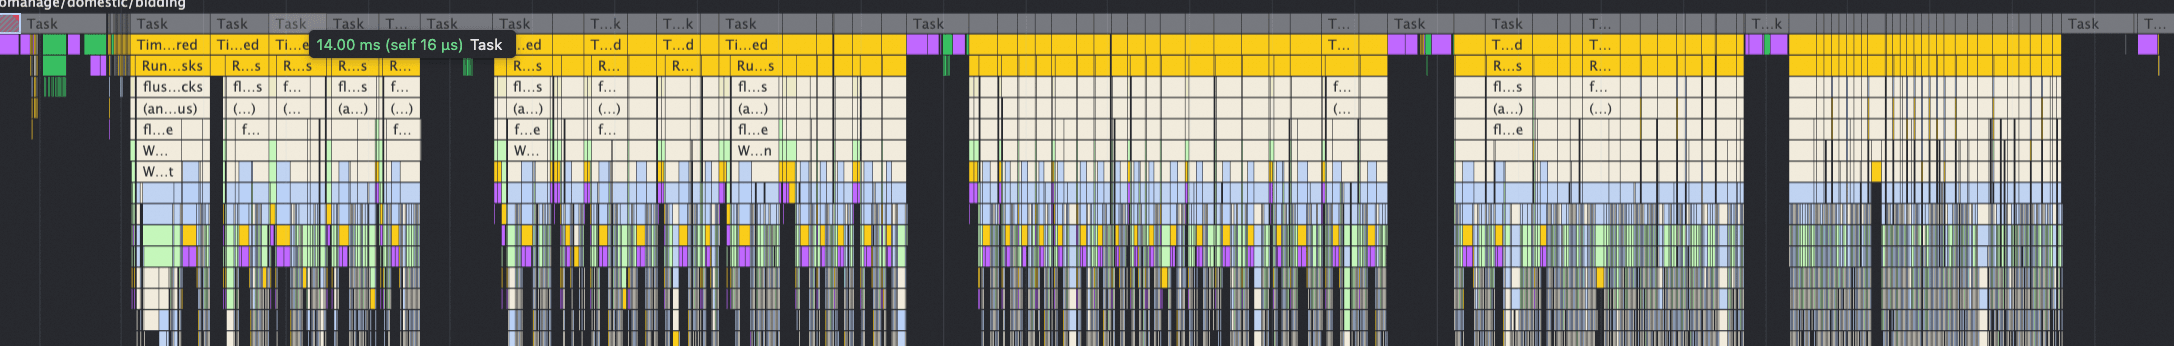
懒挂载素材组列表
自测单页 200 组素材,还是存在长任务,体验卡顿。观察 performance 发现前面只懒挂载了素材组内的素材表格,还是不够,素材组的头部也是耗时的大头,依旧用懒挂载优化。结果也是长任务消失。
行选中状态下沉到自身响应式对象
性能问题解决,但是故事还没结束,懒加载和虚拟列表方案,是会导致组件反复挂载卸载的,组件内部状态不稳定,导致选中逻辑异常
- toggleAllSelection 方法,依赖组件实例残留的 isCheckedAll 状态——组件被复用/重挂载后方向会反转。
- IO 懒挂载场景下,toggleAllSelection/checkAll 全是 no-op。所以滚动进入视口、被懒挂载的新组,其行永远没被标记选中。
解决方案:选中真相源下沉到行对象自身的响应式 $v_checked 标志
四、结果
五、思考
大数据量的渲染优化,可以有三个角度:
- 应用可视性懒挂载思想,大量数据无需全部渲染,只渲染在可视区内的组件即可;虚拟列表、滚动懒加载、图片懒加载、hover 懒挂载、展开懒挂载,都是这个思想的实践。
- 排查不规范代码引起的框架性能问题,像本文中:循环中读 computed,props 变化引起父组件更新等问题,都是我们日常开发中经常会遇到的,怎么识别出问题并解决才是关键。
- 实在无法避免的大量计算可以采用分帧处理思想,将大量计算分摊到后续帧,给浏览器留出渲染的时间,减少体感卡顿